マルチエージェント
Claude Agent SDK の本番運用|デプロイ前に決める7つのこと
この記事の要点
- Agent SDK は呼び出しのたびに claude の別プロセスを立てる。1セッション=1プロセスで、会話の記録はそのサーバーのディスクに残る
- セッションの型は「使い捨て・常駐・休眠と復帰・複数エージェント同居」の4つ。業務の長さで選ぶ
- 本番前に、会話の保存先・監視・鍵の置き場・台数・利用者ごとの分離を決めておく
Claude Agent SDK は、Claude Code と同じ仕組みの AI エージェントを自社のアプリに組み込める道具です。全体像は Claude Agent SDK とは で、自社の処理を道具として渡す方法は カスタムツール で解説しました。
今回は「作ったエージェントを、本番のサーバーでどう動かすか」です。公式ドキュメント「Hosting the Agent SDK」(2026年11月8日確認)にもとづいて、デプロイ前に決めておくこと を順番に整理します。
結論:ふつうの API サーバーとは別物として設計する
Agent SDK を本番で動かすときに、最初に押さえるべきことは1つです。エージェント1つが、長く生きるプロセス1つと、そのサーバーのディスク上の状態に結びついている という点です。
リクエストを受けて返すだけの軽い API とは違い、メモリ・ディスク・台数の考え方が変わります。決めることを表にまとめます。
| 決めること | 公式の考え方 |
|---|---|
| セッションの型 | 使い捨て・常駐・休眠と復帰・複数同居の4つから選ぶ |
| 動かす場所 | 隔離されたコンテナ(サンドボックス)の中で動かす |
| 会話の保存先 | 再開させたい会話は SessionStore で外の保存先に写す |
| 監視 | OpenTelemetry の環境変数でまとめて出す |
| 鍵の扱い | エージェントの外(手前の関所・外向きの中継)で鍵を足す |
| 台数 | 1台に載るセッション数をメモリから計算する |
| 利用者ごとの分離 | 設定・記憶・作業フォルダを利用者ごとに分ける |
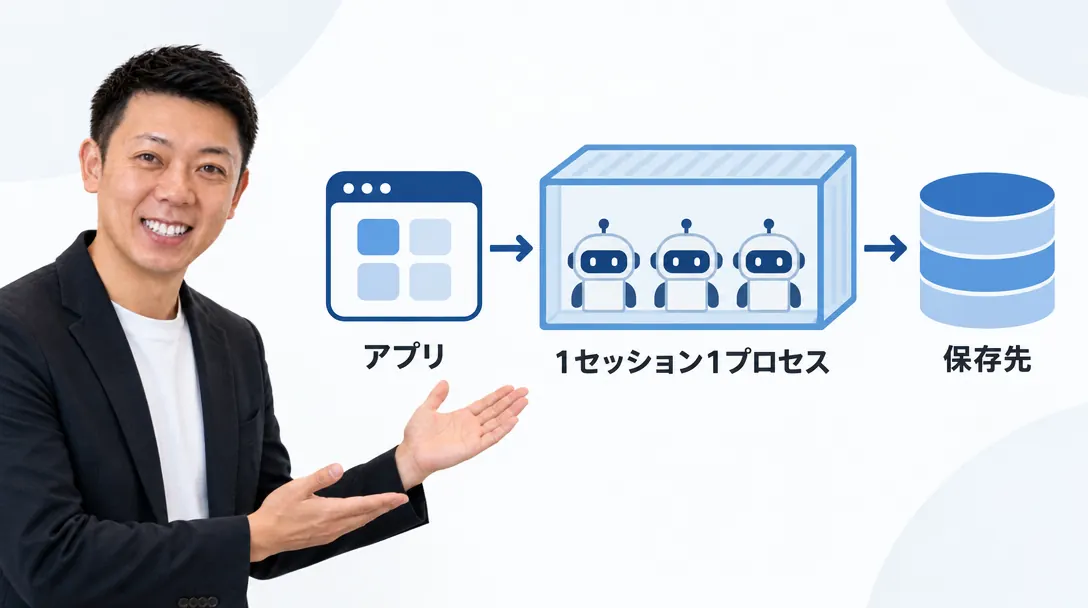
仕組み:1セッションごとに別プロセスが立つ
コードで query() を呼ぶと、SDK は claude の CLI を別プロセスとして立ち上げ、標準入出力でやりとりします。 シェル・作業フォルダ・会話の記録(JSONL)は、そのプロセスが持っています。
同時に10セッション動かせば、プロセスも10個です。何も指定しないと全部がアプリと同じ作業フォルダを使うので、ファイルを分けたいときはセッションごとに cwd を渡します。
既定では、次の3つがコンテナのディスク上にだけあります。どれもコンテナの再起動・台数の縮小・別のノードへの移動で消えます。
| 状態 | 既定の置き場 |
|---|---|
| 会話の記録 | ホーム直下の .claude/projects/(CLAUDE_CONFIG_DIR があればその下) |
| CLAUDE.md の記憶 | ユーザー用はホーム直下の .claude、プロジェクト用は作業フォルダ |
| 作業で作ったファイル | そのセッションの作業フォルダ |
セッションの型は4つ。業務の長さで選ぶ
コンテナをどれくらい生かしておくかで、4つの型に分かれます。 公式は、ここで型を選び、置き場所は別途選ぶ、という順番をすすめています。
| 型 | 動き方 | 向いている仕事の例 |
|---|---|---|
| 使い捨て | 1件ごとにコンテナを作り、終わったら壊す | 不具合の調査と修正、請求書の読み取り、文書の翻訳 |
| 常駐 | コンテナを立てっぱなしにし、複数のセッションを抱える | 受信メールの仕分け、チャットの常時対応 |
| 休眠と復帰 | 使わない間は止め、戻ってきたら保存先から会話を読み込む | ときどき相談する案件管理、何時間もかけるリサーチ |
| 複数同居 | 1つのコンテナで複数のエージェントを動かす | エージェント同士がやりとりするシミュレーション |
使い捨て型は、maxTurns(Python は max_turns)で往復の上限を決めておきます。上限に達すると結果の種類が error_max_turns になり、呼び出しがエラーを投げるので、きれいに終わらせたいなら try で囲む 必要があります。
常駐型では、TypeScript なら streamInput() で会話を足し、startup() で事前にプロセスを温めておけます。Python では ClaudeSDKClient でセッションを開いたままにします。
休眠と復帰の型では SessionStore が必須です。 保存先なしでコンテナを止めると、会話の記録ごと消えます。
動かす場所:隔離されたコンテナに入れる
SDK は、隔離されたコンテナ(サンドボックス)の中で動かすのが基本です。 プロセスの分離・資源の上限・通信の制御・使い捨てのディスクがそろうからです。考え方は Claude Code のサンドボックス とも共通します。
サービスを選ぶときに確かめる点として、公式は次を挙げています。
- 誰が運用するか(サービスに任せるか、自分たちで動かすか)
- 起動の速さ(使い捨て型は1秒未満が欲しい)
- 長く残せる保存領域があるか(休眠と復帰の型には必須)
- 料金の形(秒単位・リクエスト単位・時間単位)
- 通信の制御(外向きの許可リスト・中継・閉じたネットワークとの接続)
必要なものは、Python SDK なら Python 3.10 以上、TypeScript SDK なら Node.js 18.14 以上です。多くの場合 SDK に Claude Code 本体が同梱されていて、SDK を上げると CLI も上がります。 小さな更新は随時取り込み、機能追加の版は変更履歴を読んでから上げる、というのが公式の方針です。
資源の目安は、エージェント1つあたりメモリ 1GiB・ディスク 5GiB・CPU 1つ から。会話が長くなるほどメモリは増えるので、これは下限として扱います。
通信は、外向きに api.anthropic.com(Bedrock などを使うならその窓口)と、使う MCP サーバーへの HTTPS が要ります。本番では、許可した宛先だけを通し、鍵を足し、記録を取る外向きの中継(プロキシ) を通すよう公式はすすめています。受け付けはアプリ側のポートで行い、SDK のプロセス自体は外からの接続を待ちません。
本番前に決める4つ:保存・監視・鍵・台数
会話の保存:SessionStore は「写し」
再開させたい会話は、SessionStore で外の保存先に写します。 注意点は3つです。
- 写すのは会話の記録だけ。CLAUDE.md や作業ファイルは別に保存する
- まずローカルに書き、その写しを保存先に送る仕組み
- 送れなかったときは、その分を捨てて
mirror_errorを出し、処理は続ける。保存が大事なら、この通知を見張る
監視:環境変数で OpenTelemetry に出す
SDK は OpenTelemetry の設定を環境変数から引き継ぎます。 コンテナや配置の段階でまとめて設定すれば、どの道具がどれだけ時間を使ったか、どこで止まったかが見えるようになります。既定では、指示の文章や道具への入力は出力に含まれません。考え方は Claude Code の利用状況の監視 と同じです。
鍵:エージェントに持たせない
公式が挙げる考え方は3つです。
| 場面 | 考え方 |
|---|---|
| モデルの呼び出し | 鍵は秘密情報の管理の仕組みから渡す。または中継を通して外で鍵を足す |
| 外からのリクエスト | 認証は手前の関所で済ませ、エージェントには確認済みのリクエストだけを渡す |
| 道具が外を呼ぶとき | 道具用の鍵もエージェントの環境に置かず、外向きの中継で足す |
エージェントは呼び出すだけ、鍵を足すのは中継 という分担です。
台数:メモリから計算する
1台に載るエージェント数=(サーバーのメモリ − ほかが使う分)÷ 1セッションの最大メモリ で見積もります。最大メモリは、実際の長さと道具の使い方で代表的なセッションを動かし、ピークを測って決めます。
常駐型を横に増やすときは、ロードバランサーの後ろに並べ、セッションIDで同じコンテナに振り分け続ける と、同じプロセスを使い続けられます。
費用については、コンテナ代よりトークン代のほうが桁違いに大きくなるのがふつう と公式は書いています。最小構成のコンテナは1時間あたり約0.05ドル、長いセッションはトークンで数ドル使うこともあります。
利用者が複数いるなら、混ざらないように分ける
1つのコンテナで複数の利用者(テナント)を扱うと、設定や記憶のファイルを通じて、ある利用者の文脈が別の利用者に漏れるおそれがあります。 公式の分け方は次のとおりです。
- 設定の読み込みを止める(TypeScript は
settingSources: []、Python はsetting_sources=[]) - 自動の記憶を止める(
CLAUDE_CODE_DISABLE_AUTO_MEMORY=1)。これは設定の読み込みとは別に入るため CLAUDE_CONFIG_DIRを利用者ごとのフォルダにする- 作業フォルダを利用者ごとに分け、毎回
cwdを明示する - 外向きの中継の規則も利用者ごとに分ける
TypeScript では env が環境変数を丸ごと置き換えるので、元の環境変数も一緒に渡す必要があります。Python では上に重ねる形です。
仕事に入れるときの考え方
最初は「使い捨て型」から始めるのが安全です。 1件ごとに作って壊すので、状態の持ち越しや利用者の混ざりを気にしなくて済みます。
- 書類の読み取りや翻訳など、1回で終わる業務を使い捨て型で動かす
maxTurnsで上限を決め、監視の出力を最初から入れておく- 会話を続けたい業務が出てきたら、SessionStore を入れて休眠と復帰の型へ
なお、公式は既知の制約として、セッション全体の時間切れがない・長いセッションでメモリが増える・サブエージェントを一度に大量に出すと回数制限に当たりやすい、を挙げています。往復の上限と、プロセスの定期的な入れ替えで備えます。
エージェントの仕組み自体を自社で持つ必要がない場合は、Anthropic が動かす Managed Agents も選択肢だと公式は書いています。クラウドで Claude Code に作業させる方法は Claude Code のクラウド実行 を、自社の機械でクラウドのセッションを動かす方法は Claude Code のセルフホスト環境 を参考にしてください。
まとめ
- Agent SDK は 1セッション=1プロセス。会話の記録はそのサーバーのディスクにあり、再起動で消える
- セッションの型は 使い捨て・常駐・休眠と復帰・複数同居 の4つ。休眠と復帰には SessionStore が必須
- 本番前に、保存先・監視・鍵の置き場・台数・利用者ごとの分離を決めておく
出典
この記事はAIを使って下書きし、著者が事実確認・加筆しています。ツールの機能や料金は変わることがあるため、最新の情報は各社の公式ページでご確認ください。