マルチエージェント
サブエージェントのeffortとモデルの使い分け|Claude Code
この記事の要点
- 2026年10月の更新で、サブエージェントごとに考える深さ(effort)を指定できるようになった
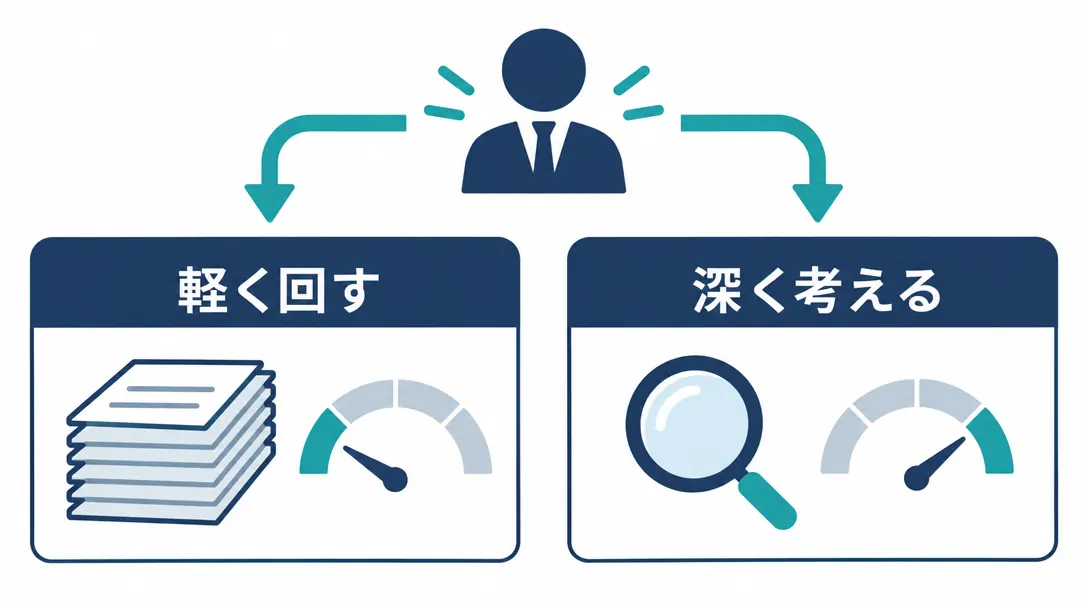
- 「量が多くて単純な仕事は軽く・間違えると困る仕事は深く」が基本の分け方
- まず全員を標準で動かし、結果を見てから1役ずつ軽く・深くしていく
Claude Code でサブエージェントを使い始めると、次に気になるのが「全部のサブエージェントを同じ設定で動かしていいのか」です。調べものも、検算も、まとめも、同じ強さで考えさせると、時間も利用量も必要以上にかかります。
2026年10月の Claude Code の更新で、サブエージェントごとに考える深さ(effort)を指定できるようになりました。この記事では、公式の変更履歴とドキュメントにもとづいて、役割ごとに深さとモデルを選び分ける考え方を紹介します。サブエージェントそのものの仕組みは、Claude Codeのマルチエージェント入門で解説しています。
結論:量が多い仕事は軽く、間違えると困る仕事は深く
選び方の基本は1つです。
- 量が多くて、1件ずつの判断が単純な仕事(資料の下読み・一覧づくり・分類)は、軽いモデルや浅い考え方で回す
- 間違えると後で困る仕事(数字の検算・事実の確認・最終のまとめ)は、深く考えさせる
全員を最も深い設定にするより、役割ごとに分けた方が、待ち時間も利用量も減り、精度が必要な所に力を集められます。
2026年10月の更新で増えた設定
公式の変更履歴で、サブエージェントの任せ方に関わる項目は次のとおりです。
| 日付・版 | 追加されたこと | 意味 |
|---|---|---|
| 10月6日(2.1.292) | Agent ツールに effort | サブエージェントを、頼んだ深さで動かせる |
| 10月8日(2.1.295) | skills の先読みは最大32個 | 最初に読み込むスキルの数に上限ができた |
| 10月9日(2.1.296) | 定義に autoCompactWindow | そのサブエージェントだけ、記憶の要約を早めに始められる |
| 10月9日(2.1.296) | CLAUDE_CODE_WORKFLOW_SUBAGENT_MODEL | ワークフローで動くサブエージェントを1つのモデルにそろえられる(ほかのサブエージェントはそれぞれのモデルのまま) |
あわせて Anthropic は10月7日に、小型モデルの Claude Haiku 5.5 を「大量で、費用を抑えたい仕事向け」として発表しています。下調べや分類のような量の多い役割の候補になります。
手順1:役割を書き出して、目安を決める
まず、いま使っている(使いたい)サブエージェントを書き出し、役割ごとに目安を付けます。
| 役割 | 仕事の性質 | モデルの目安 | 考える深さの目安 |
|---|---|---|---|
| 下読み係 | 長い資料から関係する所を抜き出す | 軽いモデル | 浅め |
| 分類係 | 問い合わせや記録を種類分けする | 軽いモデル | 浅め |
| 下書き係 | 集めた材料から文章や表を作る | 標準のモデル | 標準 |
| 検算係 | 数字・日付・固有名詞を元の資料と照らす | 標準〜上位のモデル | 深め |
| まとめ役 | 結果を1つにして、人に確認を求める | 上位のモデル | 深め |
あくまで出発点です。仕事の中身によって、下書き係を深めにした方がよい場合もあります。
手順2:定義ファイルに書く
モデルは、サブエージェントの定義ファイル(.claude/agents/ の Markdown)の model で役割ごとに指定できます。
---
name: shitayomi
description: 長い資料や記録から、頼まれたテーマに関係する部分だけを抜き出す下読み係。要約や意見は書かない。
tools: Read, Grep, Glob
model: haiku
---
頼まれたテーマに関係する部分を、元の場所(ファイル名と見出し)つきで抜き出してください。
関係があるか迷うものは「保留」として別に並べてください。
検算係は、読むだけの道具に絞り、上位のモデルを指定します。役割ごとに道具を絞る考え方は、入門記事の「仕事での役割分担の例」と同じです。
手順3:頼むときに「考える深さ」を添える
effort は、まとめ役(メインの Claude)がサブエージェントを呼ぶときに指定するものです。人からは、頼み方の中で深さを伝えます。
次の3つをサブエージェントに分けて進めて。
1. 下読み係:資料フォルダから、競合の料金に関係する所を抜き出す(考える深さは浅めでよい)
2. 下書き係:抜き出した内容で比較表を作る(標準)
3. 検算係:比較表の数字と出典が元の資料と合っているか確かめる(深く考えて)
最後に、検算で合わなかった行だけを私に見せて。
「どこを深く考えてほしいか」を言葉で書いておくと、まとめ役が深さを選びやすくなります。
使う量を抑える3つのコツ
- 最初は全員を標準で動かす:いきなり軽くすると、どこで質が落ちたか分からなくなります。結果を見てから、1役ずつ軽く・深くしていきます。
- 長い資料を読む係は、記憶の要約を早めに:
autoCompactWindowを使うと、そのサブエージェントだけ早めに要約を始められます。メインの会話に影響させずに、長い作業を続けやすくなります。 - 先読みするスキルを絞る:サブエージェントに渡すスキルは、その役割で使うものだけにします。10月の更新で先読みは最大32個までになりました。
うまくいかないときの見直し方
| 起きていること | 見直す所 |
|---|---|
| 下読みで大事な所が抜ける | 下読み係の深さを1段上げる/「迷ったら保留」と指示に書く |
| 検算が時間ばかりかかる | 確かめる対象を「数字・日付・固有名詞」に絞る |
| まとめの質がばらつく | まとめ役に、出力の型(表の列・文字数)を指示する |
| 利用量が想定より多い | 量の多い役割から順に、軽いモデルへ切り替えて結果を比べる |
よくある質問
effort を指定しないとどうなりますか?
指定しなければ、これまでどおりの動きになります。まずは指定なしで動かし、物足りない役割・時間がかかりすぎる役割だけに指定を足すのがおすすめです。
Codex でも同じように分けられますか?
考え方は同じです。Codex にもサブエージェントがあり、定義の書き方が違います。違いはCodexとClaude Codeのサブエージェントの違いで比べています。
業務の自動化にもそのまま使えますか?
使えます。たとえば問い合わせメールの一次返信をAIで下書きする仕組みなら、分類係と下書き係は軽めに、回答集にない質問を見分ける確認係は深めに、という分け方が考えられます。
設定やモデルの名前は変わりませんか?
変わることがあります。使う前に、公式の変更履歴とドキュメントで最新の名前と書き方を確認してください。
出典:Anthropic「Claude Code changelog」(2026年10月15日確認) https://code.claude.com/docs/en/changelog / Anthropic「Create custom subagents」(2026年10月15日確認) https://code.claude.com/docs/en/sub-agents / Anthropic「Claude Haiku 5.5」(2026年10月15日確認) https://www.anthropic.com/claude-haiku-5-5
この記事はAIを使って下書きし、著者が事実確認・加筆しています。ツールの機能や料金は変わることがあるため、最新の情報は各社の公式ページでご確認ください。